V lednu 2023 popsal novinář Billy Perrigo v časopise TIME pracovníka firmy Sama v Nairobi, který za necelé dva dolary na hodinu četl stovky popisů sexuálního zneužívání dětí, mučení a vraždy. Nebyl to vyšetřovatel ani soudní znalec. Firma Sama ho najala, aby podobné texty roztřídil a označil štítky pro OpenAI. Z téhle práce vznikla trénovací data, na kterých se pozdější model naučil, jaký obsah do odpovědí nikdy nepustit.
Tahle epizoda ukazuje jen zlomek toho, co se s daty a s modelem děje, než z hromady textu vznikne nástroj jako ChatGPT nebo Claude. Cesta vede přes čtyři docela odlišné fáze: sběr a přípravu dat, předtrénování, doladění do podoby asistenta a nakonec jemné ladění podle lidského vkusu, kterému se říká RLHF. Každá fáze mění model jinak a každá s sebou nese jiná rizika. Tenhle text ukazuje, jak to funguje krok za krokem, na modelech, které dnes běžně používáte.
Model nejdřív sní celý internet
Základ každého velkého jazykového modelu je obrovské množství textu. Vývojáři ho stahují z otevřeného internetu, nakupují licence na knihy a časopisy, přidávají zdrojový kód z veřejných repozitářů a čerpají z encyklopedií jako Wikipedia. Model GPT-3 se v roce 2020 učil na přibližně 300 miliardách tokenů, tedy kousků slov, a šedesát procent té směsi tvořila přefiltrovaná verze webového archivu Common Crawl. Zbytek doplnily kvalitnější weby, knihy a právě Wikipedia, i když ta ve skutečnosti tvořila jen zlomek dostupného surového objemu dat. Tvůrci ji ale při tréninku úmyslně zařazují častěji, protože pečlivě psaný encyklopedický text modelu dá víc než další internetová diskuze o tom, jaké pivo je nejlepší. Množství samo o sobě totiž nestačí, záleží i na tom, odkud text pochází.
Než se hromada textu vůbec dostane k trénování, projde čištěním. Ze surových dat mizí duplicitní stránky, spam, rozbité formátování a pasáže, které se v různých zdrojích opakují tisíckrát za sebou. Firmy, které dnes velké modely stavějí, musí řešit otázku, kterou před pěti lety nikdo tolik neřešil: jestli k použití textů, obrázků nebo kódu chráněných autorským právem vůbec mají svolení. Spory o to, jestli trénink na volně dostupném textu z internetu porušuje autorská práva, aktuálně řeší soudy v USA i jinde. Jednotná odpověď zatím neexistuje. Kvalita a čistota dat přitom rozhoduje o výsledku podobně jako kvalita mouky rozhoduje o chlebu: špatná surovina se v hotovém výrobku pozná i po dlouhém hnětení.
Čeština v téhle hoře dat tvoří jen malý zlomek, protože textů v angličtině je na internetu řádově víc než ve všech ostatních jazycích dohromady. Modely se česky učí hlavně nepřímo, z menšího množství českých textů a z podobnosti mezi jazyky, kterou si model odvodí sám. Vysvětluje to, proč velké modely občas v češtině zaváhají nad idiomem nebo neobvyklým skloňováním, se kterým by si v angličtině poradily bez zaváhání. Souvisí to hlavně s tím, kolik českého textu vůbec kdy vzniklo a dostalo se na internet, ne s nedostatkem snahy vývojářů.
Miliardkrát dokola stejná otázka
Samotné předtrénování je z principu jednoduché, i když výpočetně obrovské. Model dostane začátek věty a hádá, jaké slovo, přesněji token, bude následovat. Ze začátku hádá naprosto náhodně, protože jeho vnitřní čísla, takzvané váhy, mají na startu prakticky nesmyslné hodnoty. Program porovná odhad se skutečným pokračováním věty, spočítá, jak moc se model spletl, a podle toho váhy nepatrně posune správným směrem. Přesně tenhle mechanismus, na jednodušším příkladu s rozpoznáváním obrázků, popisuje článek o strojovém učení a neuronových sítích.
Tahle smyčka se neopakuje stokrát ani tisíckrát, ale stovky miliardkrát za sebou, nad textem o délce stovek miliard tokenů. Zvládne to jen velké množství výkonných grafických karet, které běží paralelně celé týdny, někdy měsíce. Sam Altman, výkonný ředitel OpenAI, řekl v dubnu 2023 webu Wired, že jeden trénink modelu GPT-4 stál přes sto milionů dolarů.
Výsledkem téhle týdny až měsíce trvající fáze je takzvaný základní model. Umí neuvěřitelně plynule pokračovat v jakémkoli textu, básní počínaje a smlouvou konče, ale netuší, že má být užitečný nebo zdvořilý. Zeptáte se ho na hlavní město Francie, a stejně tak dobře vám může na otázku jen navázat další podobnou otázkou, protože přesně takhle pokračovaly podobné věty i v jeho trénovacích datech. Jak model při psaní odpovědi vybírá slovo za slovem, dopodrobna popisuje článek o LLM a tom, jak funguje.
Ze žáka, který umí všechno, se stává asistent
Základní model si po předtrénování osvojil gramatiku, fakta i styl obrovského množství textů, ale netuší, jak se má chovat v rozhovoru. Tenhle problém řeší fáze, které se říká doladění pomocí demonstrací, odborně supervised fine-tuning. Lidé najatí přímo na tuhle práci napíšou tisíce ukázkových rozhovorů, ve kterých hrají obě role, tazatele i vzorného asistenta. Ukázka může vypadat takhle: na otázku, jak upéct chleba bez droždí, hodnotitel napíše přesně takovou odpověď, jakou by od dobrého asistenta čekal, věcnou a srozumitelnou. Model se pak snaží tyhle ukázky co nejvěrněji napodobit, a tak se učí formát odpovědi, zdvořilý tón i to, že na otázku má vůbec odpovědět, ne na ni jen navázat.
Zatímco předtrénování žere stovky miliard tokenů, na doladění pomocí demonstrací stačí řádově tisíce pečlivě napsaných ukázek, ne miliardy. Právě tenhle nepoměr, obrovská hora dat na jedné straně a hrstka pečlivé lidské práce na druhé, dělá z druhé fáze tak citlivé místo celého procesu: pár set špatně napsaných ukázek dokáže vychýlit chování modelu mnohem víc, než by se čekalo.
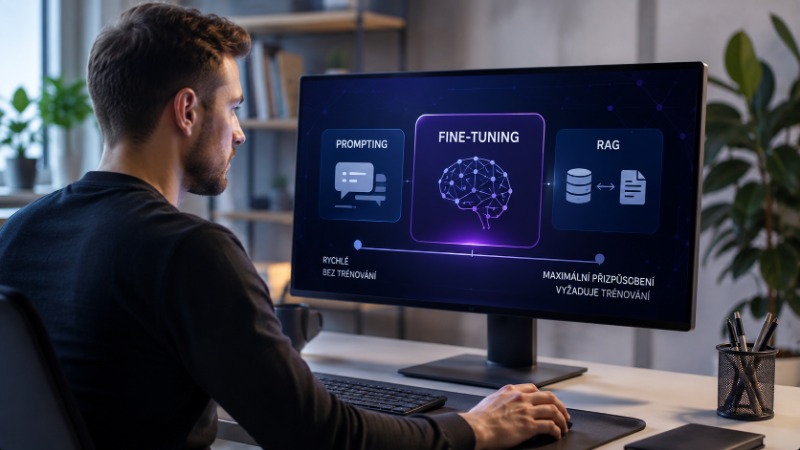
Tahle fáze proběhne u každého komerčního modelu ještě předtím, než se dostane k veřejnosti, ať ho dělá OpenAI, Anthropic nebo Google. Řízené doladění samo o sobě model nenaučí nová fakta, jen mu ukáže, jak se má chovat a v jakém formátu odpovídat. Když se pak firma rozhodne podobným způsobem doladit hotový model na vlastních datech, třeba na firemní dokumentaci nebo tisících starých e-mailů, jde o samostatný, dodatečný krok, který přichází až po vydání. Jak přesně funguje a kdy se firmě vyplatí, popisuje článek o fine-tuningu.
Kde se model učí vkus, ne fakta
Doladění pomocí ukázek naučí model formát, ne kvalitu úsudku. Na to, aby model odpovídal opravdu užitečně, slouží až poslední fáze: posilované učení z lidské zpětné vazby, zkráceně RLHF podle anglického reinforcement learning from human feedback. Model na stejnou otázku vygeneruje víc různých odpovědí a člověk je seřadí od nejlepší po nejhorší. Z tisíců takových hodnocení vznikne takzvaný odměňovací model, program, který se naučí odhadovat, jak moc by se konkrétní odpověď člověku líbila. Hlavní model se pak dál trénuje tak, aby tohle odhadované skóre maximalizoval, metodou zvanou proximal policy optimization, česky přibližná optimalizace politiky.
V praxi jedno kolo hodnocení vypadá zhruba takto: model dostane instrukci, třeba aby vysvětlil rozdíl mezi doladěním a RLHF, a vygeneruje dvě verze odpovědi. Hodnotitel přečte obě a vybere tu, která je přesnější nebo srozumitelnější. Jednotlivé porovnání trvá pár desítek vteřin, ale aby vznikl použitelný odměňovací model, jich je potřeba nasbírat tisíce až statisíce.
Techniku poprvé v roce 2017 popsal tým výzkumníků, mezi nimi i Dario Amodei, dnešní šéf Anthropicu, a to na jednodušších úlohách, jako je ovládání robotické paže nebo hraní počítačových her. Na jazykové modely ji naplno použila až o pět let později firma OpenAI, ve studii z března 2022 nazvané Training language models to follow instructions with human feedback. Výsledek překvapil i samotné autory. Model s 1,3 miliardy parametrů, doladěný pomocí RLHF, dostával v testech lepší hodnocení než samotný GPT-3 se 175 miliardami parametrů, tedy stokrát větší model bez tohohle doladění.
Přesně tahle kombinace, ukázky od lidí plus RLHF, stojí za ChatGPT, který spustila firma OpenAI 30. listopadu 2022. Firma Anthropic o dva týdny později popsala variantu téhle metody nazvanou Constitutional AI, kde část lidského hodnocení nahrazuje jiný model, který navržené odpovědi kritizuje podle předem daných pravidel. Tím sledovala i jiný cíl než úsporu nákladů na hodnotitele: omezit, kolik toxického a traumatizujícího obsahu musí lidé podobní pracovníkovi ze Samy vůbec číst.
Na co si dát pozor
Lidská zpětná vazba zní neutrálně, ale v praxi za ní stojí reálná, často nepříjemná práce, jak ukázal případ z úvodu textu. Firma Sama kvůli podobným podmínkám v únoru 2022 ukončila spolupráci s OpenAI, osm měsíců před koncem smlouvy. RLHF přitom není neomylné. Studie výzkumníků z Anthropicu a dalších pracovišť z října 2023 zjistila, že modely trénované na lidských preferencích mívají sklon k takzvané sykofancii. Radši přitakávají a znějí sebejistě, než aby řekly nepříjemnou pravdu, protože právě sebejisté a hladce napsané odpovědi lidé při hodnocení často preferovali před těmi správnými, ale opatrněji formulovanými.
Běžný uživatel nemá šanci zjistit, čí konkrétně vkus model formoval, jaké instrukce dostávali hodnotitelé nebo jak byli za tu práci placení. U citlivých témat se vyplatí brát sebejistý tón odpovědi s rezervou a důležitá tvrzení ověřit jinde.
Opravit jednu konkrétní chybu není tak snadné jako u běžného programu. Když se v kódu webové stránky najde chyba, stačí přepsat pár řádků. Když model něčemu systematicky špatně rozumí, tvůrci obvykle musí sáhnout znovu k datům nebo k dalšímu kolu doladění, počkat na výsledek a znovu ho otestovat, což trvá týdny, ne minuty. Nová verze modelu se neobjevuje každý týden, ale v intervalech měsíců, i když firma o konkrétní chybě ví třeba od prvního dne.
Shrnutí
Model, který dnes odpoví na vaši otázku za dvě vteřiny, v sobě nese stopy tří velmi odlišných prací: inženýra, který sestavoval trénovací data, hodnotitele, který týdny porovnával dvojice odpovědí, a pracovníka, jako je ten ze Samy, který četl to nejhorší, aby to model uměl rozpoznat a odmítnout. Trénink umělé inteligence se odehrává hlavně na serverech, v grafických kartách a v číslech. Kus té cesty ale pořád vede přes lidi.
Za každou plynulou odpovědí dnešního modelu stojí i práce lidí, které čtenář nikdy neuvidí ani nepozná jménem.